척추체 자동 검출·라벨링 연구 Post-mortem
1. Original Goal — 최초 연구 목표
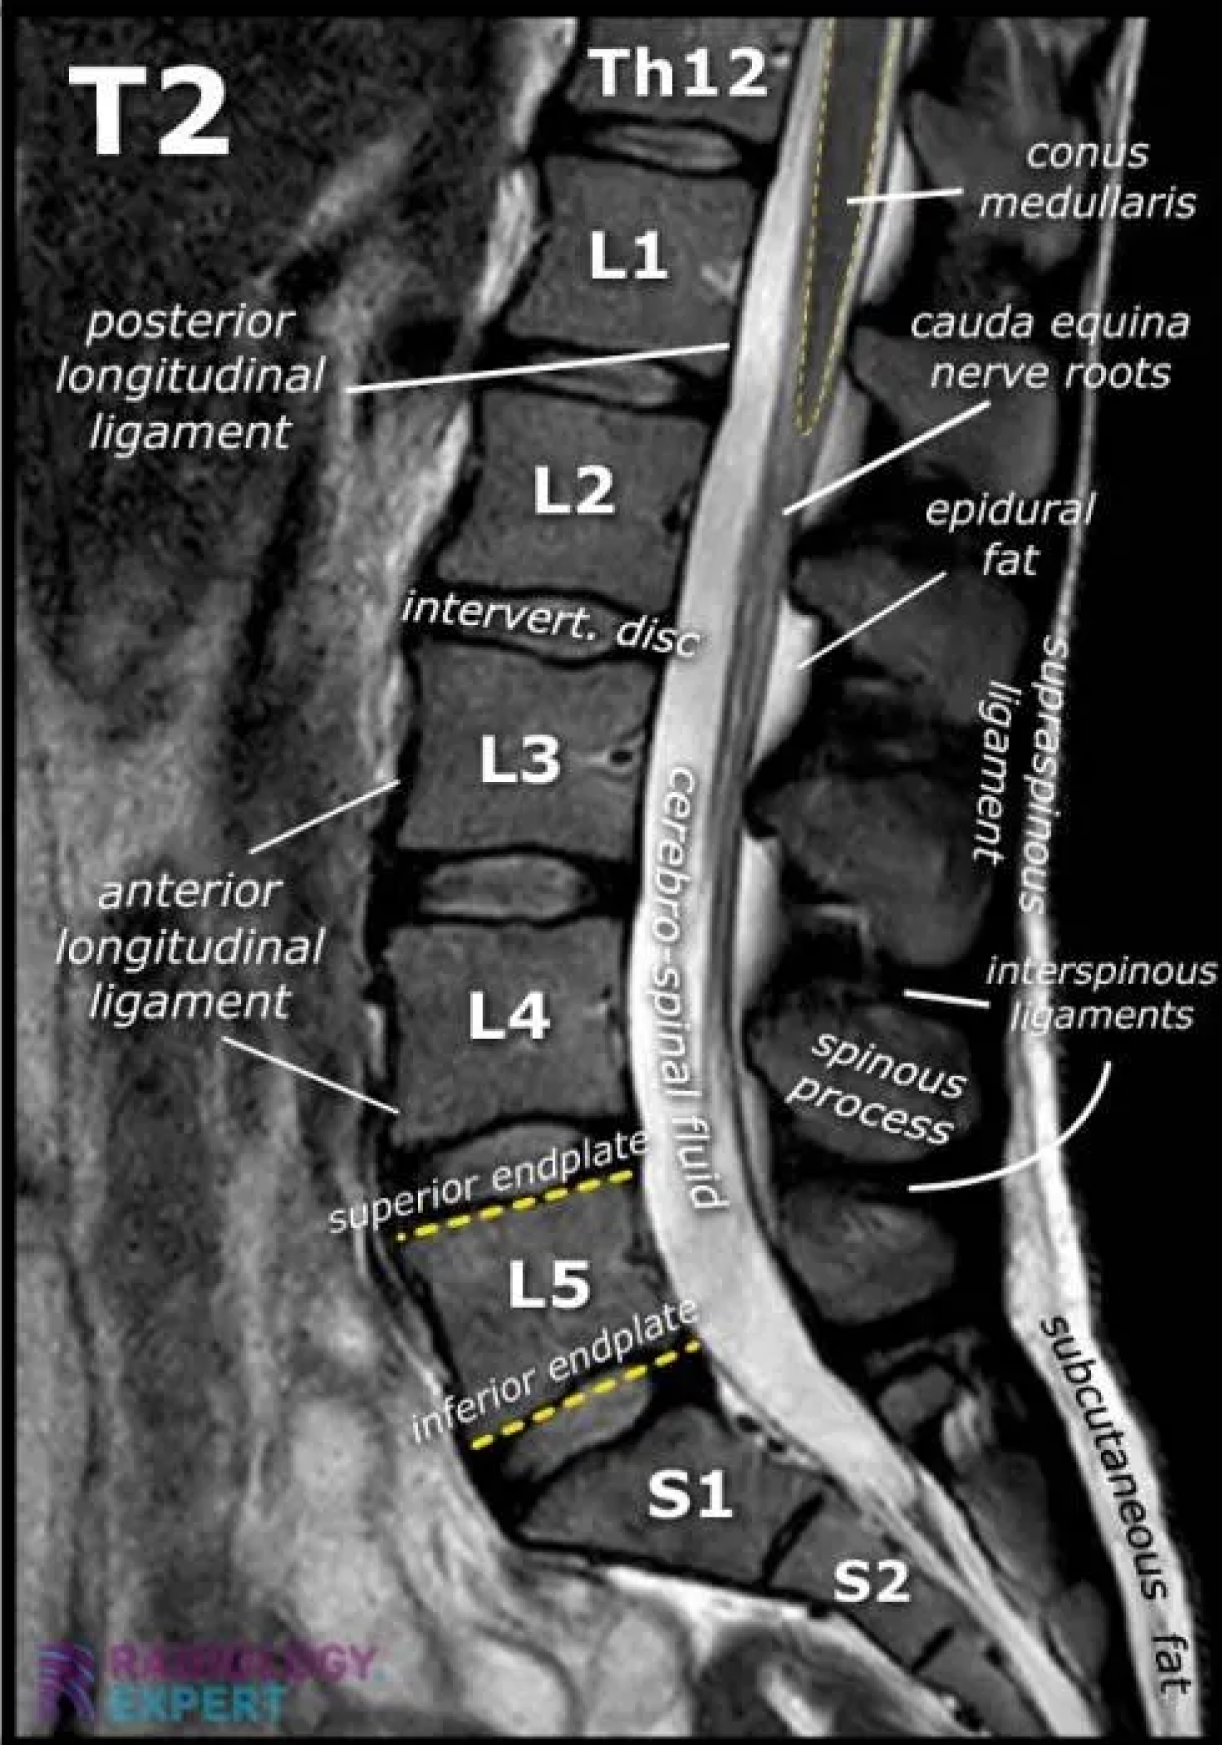
본 연구의 최초 목표는 MRI 영상에서 척추체를 자동으로 검출하고 각 척추체의 레벨을 자동으로 라벨링하는 시스템을 개발하는 것이었다.
단순히 정상적인 척추 배열에서 L1~L5를 검출하고 라벨링하는 것에 그치지 않고,
- 천추의 요추화(Lumbarization)
- 요추의 천추화(Sacralization)
와 같은 해부학적 변이가 존재하는 경우까지 고려하여 올바른 척추체 레벨을 자동으로 판단하고 라벨링하는 것을 주요 목표로 설정하였다.
즉 최초 목표는 단순한 척추체 Object Detection이 아니라,
MRI → 척추체 자동 검출 → 척추 레벨 자동 라벨링 → 해부학적 변이 대응
까지 수행하는 자동 라벨링 시스템을 구축하는 것이었다.
2. Original Motivation — 왜 이 연구를 시작했는가
연구를 시작한 목적은 크게 두 가지였다.
2.1 임상 연구자의 수작업 라벨링 부담 감소
임상 연구에서 척추 MRI 데이터를 활용하기 위해 연구자들이 직접 영상의 척추체를 확인하고 각 척추 레벨을 라벨링해야 하는 과정이 필요했다.
부천 성모 병원 안00 교수님께서도 임상 연구원들이 이러한 라벨링 작업을 직접 수행하는 데 시간이 소요되기 때문에 이를 자동화할 수 있으면 연구 과정에 도움이 될 수 있다는 문제를 제시하였다.
따라서 척추체 검출과 레벨 라벨링을 자동화하여 임상 연구자의 반복적인 데이터 라벨링 작업과 데이터 구축 시간을 줄이는 것을 목적으로 하였다.
2.2 CNN 등 AI 연구를 위한 GT 구축 부담 감소
척추 MRI를 활용하는 CNN 등의 지도학습 연구에서는 척추체의 위치와 레벨이 라벨링된 Ground Truth(GT) 데이터가 필요하다.
새로운 데이터셋을 구축할 때 연구자가 직접 MRI 영상을 확인하면서 척추체 위치와 레벨을 하나씩 라벨링해야 한다.
따라서 자동 라벨링 시스템을 구축하면 AI 연구자가 학습 데이터셋과 GT를 구축하는 과정에서 필요한 수작업을 줄일 수 있을 것이라고 판단하였다.
최초에 기대했던 전체적인 가치는 다음과 같았다.
MRI
→ 척추체 자동 검출
→ 척추 레벨 자동 라벨링
→ 요추화·천추화 등의 해부학적 변이 대응
→ GT 생성
→ 임상 연구자 및 AI 연구자의 수작업 감소
3. Original Assumptions — 연구 시작 당시의 가정
연구 초기에는 주로 다음과 같은 기술적 가정을 중심으로 연구를 시작하였다.
3.1 기존 자동 라벨링 방법의 한계
기존 척추체 자동 검출 및 라벨링 방법은 정상적인 척추 배열에서는 동작할 수 있지만, 천추의 요추화 또는 요추의 천추화와 같은 해부학적 변이가 존재할 경우 정확한 척추 레벨을 결정하는 데 한계가 있을 것이라고 판단하였다.
3.2 해부학적 변이 대응의 가치
따라서 이러한 변이까지 처리할 수 있는 자동 라벨링 방법을 개발한다면 기존 방법보다 신뢰도 높은 척추체 라벨링 및 GT 생성이 가능하고, 임상 연구와 AI 연구 데이터 구축 과정에서 가치가 있을 것이라고 가정하였다.
3.3 MRI 기반 자동 판별 가능성
MRI 영상의 척추체 위치, 배열, 형태 및 모델의 예측 결과 등을 이용하면 요추화·천추화가 존재하는 경우에도 척추 레벨을 자동으로 추론할 수 있을 것이라고 생각하였다.
3.4 연구 이후 발견한 누락된 선행 가정
Post-mortem 과정에서 위의 기술적 가정보다 먼저 검증했어야 하는 질문들이 존재했다는 것을 발견하였다.
A. Problem Significance
임상 연구자와 AI 연구자가 수행하는 척추체 수동 라벨링 작업이 실제로 자동화가 필요할 정도로 충분히 큰 시간적·업무적 비용인가?
B. Automation Utility
충분히 정확한 자동 라벨링 시스템이 제공된다면 실제 연구 과정에서 의미 있는 효율 향상이 발생하는가?
C. Information Sufficiency / Feasibility
천추화와 요추화를 판단하기 위해 필요한 정보가 현재 가지고 있는 MRI 데이터에 실제로 존재하는가?
연구 당시에는 이러한 질문을 명시적인 연구 가설로 검증하지 않고 기술적인 문제로 바로 진입하였다.
즉 실제 연구 흐름은,
해결할 가치가 있는가?
해결에 필요한 정보가 존재하는가?
를 먼저 검증하기보다,
어떻게 해결할 것인가?
에서 시작되었다.
4. What Actually Happened — 실제 연구 진행 과정
4.1 연구 문제 설정
연구는 요추 MRI에서 척추체를 자동으로 검출하고 각 척추체의 레벨을 자동 라벨링하는 것에서 시작하였다.
특히 기존 방법에서 문제가 될 수 있다고 판단한 천추의 요추화와 요추의 천추화 같은 해부학적 변이를 고려하여, 정상적인 척추뿐만 아니라 변이가 존재하는 경우에도 올바른 척추 레벨을 결정하는 것을 주요 차별점으로 설정하였다.
그러나 이 단계에서 연구의 임상적·실용적 가치와 현재 데이터로 문제를 해결할 수 있는지를 충분히 검증하지 않은 상태에서 기술적인 해결 방법 탐색으로 진입하였다.
4.2 초기 연구 수행 방식
연구 초기에는 머신러닝 연구 및 모델 학습 과정에 대한 충분한 이해가 갖추어지지 않은 상태에서 척추체 자동 라벨링 모델을 구현하는 것부터 연구를 시작하였다.
당시에는 다음과 같은 개념에 대한 이해가 충분하지 않았다.
- 모델을 왜 새롭게 Train해야 하는지
- 기존 모델이 어떠한 데이터와 목적을 기반으로 학습되었는지
- MRI 데이터셋이 어떤 특성을 가지고 있는지
- 데이터셋을 연구에서 어떻게 활용해야 하는지
- 학습 데이터와 GT가 어떤 역할을 하는지
- 기존 Pretrained Model을 활용할 수 있는 범위가 어디까지인지
- 모델의 출력 결과를 어떻게 평가해야 하는지
- 연구 전체가 어떠한 순서로 진행되어야 하는지
따라서 초기 연구는
연구 문제 이해 → 데이터 이해 → 선행연구 조사 → 가설 설정 → 실험 설계 → 모델 선택 → 학습 → 평가
의 순서보다,
자동 라벨링이 필요함 → 라벨링 모델을 만들어보자 → 데이터를 넣음 → 학습 → 라벨링이 제대로 되지 않음 → 원인을 찾고 모델 수정
의 형태에 가까웠다.
연구를 수행하면서 동시에 머신러닝과 연구 방법론 자체를 학습하는 형태가 되었다.
4.3 데이터 및 GT 확인
제공된 MRI 데이터와 기존 GT를 기반으로 학습 및 평가 환경을 구성하였다.
연구 과정에서 동일한 척추 레벨이 중복으로 라벨링된 사례 등 GT 자체에도 데이터 품질 문제가 존재한다는 사실을 발견하였다.
이에 따라 GT 오류가 모델 학습과 평가에 영향을 미치지 않도록 데이터 검증 및 정제 과정이 필요해졌다.
이 과정 역시 모델을 학습하기 전에 데이터셋의 구조와 품질을 먼저 충분히 분석했어야 한다는 점을 보여주었다.
4.4 모델 개발 및 반복적인 변경
초기에는 MRI 영상에서 척추체를 검출하고 각 척추체의 레벨을 예측하는 모델을 개발하는 데 집중하였다.
모델이 기대한 수준으로 라벨링하지 못하면 주된 질문은
"왜 라벨링이 제대로 되지 않는가?"
였다.
반면,
- 이 실험은 어떤 가설을 검증하는가?
- 왜 이 모델을 사용하는가?
- 현재 데이터로 이 문제를 해결할 수 있는가?
- 기존 방법과 무엇을 비교해야 하는가?
- 어떤 결과가 나오면 이 접근이 실패했다고 판단할 것인가?
와 같은 질문은 충분히 다루지 못하였다.
문제가 발생할 때마다 모델과 방법론을 변경하면서 실험이 반복되었다.
4.5 척추 배열 기반 라벨링 보정
개별 척추체의 클래스 예측만으로는 오분류가 발생할 수 있기 때문에 척추가 해부학적으로 연속된 배열을 가진다는 정보를 활용하는 방법을 시도하였다.
모델이 출력한 클래스 확률을 기반으로 상대적으로 신뢰도가 높은 척추체를 Anchor로 설정하고, 이를 기준으로 위·아래 척추의 연속적인 배열을 구성하여 최종 라벨을 결정하는 파이프라인을 개발하였다.
대략적인 구조는 다음과 같았다.
척추체 검출
→ 클래스별 예측 확률
→ Anchor 선택
→ 위·아래 척추의 연속 배열 구성
→ 후보 배열 평가
→ 최종 라벨 결정
이 과정에서 여러 scoring 방법과 라벨링 전략을 적용하며 파이프라인을 반복적으로 수정하였다.
4.6 Baseline 및 성능 분석 문제
연구 초기에는 Baseline의 역할 자체를 충분히 이해하지 못하였다.
따라서 새로운 방법을 적용했을 때,
"현재 모델의 성능이 얼마인가?"
를 중심으로 결과를 확인하였다.
그러나 실제로 확인했어야 하는 것은,
- 기존 방법의 성능은 얼마인가?
- 내가 변경한 방법으로 얼마나 개선되었는가?
- 무엇 때문에 성능이 개선되었는가?
- 어떤 환자 또는 클래스에서 개선되었는가?
- 어떤 오류 유형이 감소하였는가?
등이었다.
성능 변화와 모델 변경 사이의 관계를 충분히 분석하지 못했고, 여러 요소가 변경된 상태에서 성능을 비교하는 경우도 발생하였다.
따라서 실험 결과가 하나의 연구적 지식으로 충분히 축적되지 못하였다.
4.7 생성형 AI 사용과 연구 통제력 저하
연구 과정에서 생성형 AI를 코드 작성, 오류 해결, 새로운 방법 탐색 등에 적극적으로 활용하였다.
AI 사용 자체가 문제였던 것은 아니다.
문제는 연구가 진행되면서 AI가 제안한 코드와 방법을 연구자인 내가 충분히 이해하고 통제하지 못하는 상황에서도 실험이 계속되었다는 것이었다.
어느 시점부터는,
연구자가 가설을 정의 → AI가 구현 보조
하는 형태보다,
문제 발생 → AI에게 질문 → 새로운 방법 제안 → 코드 수정 → 실행 → 새로운 문제 → 다시 AI에게 질문
하는 형태에 가까워졌다.
결과적으로 실험 횟수와 코드의 복잡성은 증가했지만, 각 변경의 이유와 결과를 연구자가 완전히 통제하기 어려워졌다.
4.8 임상적 판단 방식과 연구 접근법의 차이 발견
연구가 진행된 이후 중요한 문제가 확인되었다.
천추의 요추화와 요추의 천추화를 정확하게 판단하기 위해 전문의는 제한된 요추 MRI의 척추 배열만을 보는 것이 아니라, 더 넓은 해부학적 범위에서 척추의 시작점을 확인하고 전체적인 vertebral numbering을 수행한다는 점이었다.
즉 제한된 요추 MRI 내부에서 상대적으로 신뢰도가 높은 척추체를 Anchor로 잡고 주변 배열을 통해 합리적인 레벨을 추론하는 것은 기술적으로 가능한 접근일 수 있지만, 임상적으로 정답을 판단하는 데 필요한 정보 자체가 현재 입력 데이터에 충분하지 않을 가능성이 존재하였다.
따라서 문제는 Anchor 알고리즘의 성능을 얼마나 높일 수 있는가에 앞서,
"정답을 판단하기 위해 필요한 정보가 현재 데이터에 존재하는가?"
라는 질문을 먼저 검증했어야 한다는 것이었다.
4.9 연구 종료
연구 후반에는 기술적인 구현 가능성과 별개로 해당 연구가 실제 임상 및 연구 현장에서 제공하는 가치와 문제 자체의 해결 가능성을 다시 검토하게 되었다.
결과적으로 현재 연구 방향을 계속 발전시키는 것의 임상적·연구적 의미가 충분하지 않다고 판단하여 연구를 종료하였다.
5. What Went Wrong — 무엇이 잘못되었는가
5.1 연구 전체 프로세스를 이해하지 못한 상태에서 시작함
연구가 어떠한 단계로 진행되어야 하는지 이해하지 못한 상태에서 모델 개발부터 시작하였다.
따라서 연구 질문과 실험 설계보다 데이터를 넣고 모델을 학습하는 것이 연구의 시작점이 되었다.
5.2 데이터의 의미와 임상적 배경을 충분히 이해하지 못함
데이터가 어떤 환자와 상황에서 만들어졌으며 어떠한 임상적 의미를 가지는지 충분히 이해하지 못했다.
특히 데이터사이언스 연구에서 왜 임상적 의미를 고려해야 하는지를 제대로 이해하지 못한 상태였다.
그 결과 연구를
"임상 문제를 데이터와 AI를 이용해 해결한다"
보다
"MRI에서 척추체를 정확하게 라벨링하는 모델을 만든다"
는 기술적 문제로 받아들였다.
5.3 문제의 가치와 해결 가능성을 먼저 검증하지 않음
연구에서는 기술적인 문제 해결 가능성에 집중했지만,
이 문제를 해결할 필요가 있는가?
그리고
현재 데이터로 이 문제를 해결할 수 있는가?
를 먼저 검증하지 않았다.
이는 연구 후반에 발견된 임상적 가치와 데이터 적합성 문제로 이어졌다.
5.4 연구 질문과 가설이 명확하지 않음
"무엇을 증명하면 이 연구가 성공하는가?"
라는 질문에 명확하게 답할 수 있는 기준이 부족했다.
따라서 실험 결과가 좋지 않을 경우 가설을 기각하거나 수정하기보다 새로운 모델과 방법을 시도하는 방향으로 연구가 진행되었다.
5.5 Baseline 없이 절대적인 성능에 집중함
모델 성능을 측정하는 것과 연구 가설을 검증하는 것을 충분히 구분하지 못하였다.
따라서 현재 모델의 Accuracy, Recall, mAP 등의 수치를 확인했지만,
기존 방법과 비교하여 얼마나 개선되었으며 왜 개선되었는가
를 충분히 분석하지 못하였다.
5.6 성능 변화의 원인을 분석하지 못함
모델이나 알고리즘을 변경한 후 성능이 변화하면 수치는 확인했지만,
어떤 변경 요소가 어떤 데이터와 오류 유형에 영향을 주어 해당 성능 변화가 발생했는지
충분히 분석하지 못하였다.
즉,
Metric 확인
에서 끝나는 경우가 많았고,
Metric → Interpretation → Research Conclusion
으로 연결하지 못하였다.
5.7 모델과 방법론이 반복적으로 변경됨
명확한 가설과 평가 기준이 없었기 때문에,
가설 → 실험 → 결과 → 분석 → 다음 가설
보다
모델 실행 → 문제 발생 → 다른 방법 적용 → 다시 실행
의 과정이 반복되었다.
5.8 AI에 대한 연구 통제력을 잃음
AI를 사용했다는 것이 문제가 아니라, AI가 제안한 방법을 연구자가 충분히 이해하지 못한 상태에서도 연구가 계속되었다는 것이 문제였다.
현재 코드가 무엇을 수행하는지, 왜 이 방법을 사용하는지, 이전 방법과 무엇이 달라졌는지를 완전히 설명하기 어려운 상태에서도 코드와 실험이 계속 변경되었다.
6. Root Cause Analysis — 근본 원인 분석
이번 연구의 문제는 하나의 기술적 실패가 아니라 여러 단계의 문제가 연쇄적으로 발생한 결과였다.
6.1 Root Cause A — 연구 가치에 대한 선행 검증 부족
연구는
"이 문제는 해결할 가치가 있는가?"
보다
"이 문제를 어떻게 기술적으로 해결할 것인가?"
에서 시작되었다.
임상 연구자의 실제 라벨링 비용, 자동화의 효용, AI 연구자의 GT 구축 workflow 등을 충분히 검증하지 않았다.
6.2 Root Cause B — 문제 해결 가능성에 대한 선행 검증 부족
연구하고자 하는 문제를 정의한 뒤 바로 알고리즘 개발로 넘어갔다.
그러나 그 사이에는 반드시
"이 문제의 정답을 판단하려면 어떤 정보가 필요한가?"
라는 단계가 필요했다.
천추화와 요추화를 판단하기 위해 전문의가 실제로 어떠한 정보를 사용하는지를 먼저 확인하고,
그 정보가 현재 MRI 데이터에 존재하는가?
를 검증했어야 한다.
필요한 정보가 입력 데이터에 존재하지 않는다면 알고리즘을 아무리 개선하더라도 임상적으로 정확한 판단에는 구조적인 한계가 존재한다.
6.3 Root Cause C — 연구 프로세스에 대한 이해 부족
연구를
Problem → Question → Hypothesis → Experiment → Evidence → Conclusion
의 과정으로 이해하기보다 모델을 학습하고 성능을 높이는 과정으로 받아들였다.
따라서 모델링 능력의 부족보다 연구를 구조화하고 실험을 설계하는 방법론에 대한 이해 부족이 더 근본적인 문제였다.
6.4 Root Cause D — 데이터 중심이 아닌 모델 중심 접근
연구 질문에 필요한 정보가 데이터에 존재하는지 확인하기보다 모델을 어떻게 학습시킬지에 집중하였다.
실제로 GT 오류 등의 문제도 모델 개발 이후 연구 과정에서 발견되었다.
연구는
Dataset → Model
이 아니라
Research Question → Required Evidence → Dataset Suitability → Model
의 순서로 진행되어야 했다.
6.5 Root Cause E — Baseline과 통제된 실험 구조의 부재
새로운 방법의 절대적인 성능에 집중했고 비교 기준인 Baseline을 명확히 설정하지 못하였다.
또한 여러 요소를 동시에 변경하면서,
어떤 변경 → 어떤 성능 변화
가 발생했는지를 명확히 분석하기 어려웠다.
실험은 하나의 가설을 검증하도록 통제되어야 했다.
예를 들어,
Hypothesis
척추 배열 정보를 사용하면 독립적인 클래스 예측보다 라벨링 오류가 감소한다.
Baseline
모델의 클래스 예측만으로 최종 라벨 결정
Experiment
동일한 모델 출력에 척추 배열 기반 보정만 추가
Comparison
Baseline vs. Proposed Method
Analysis
전체 성능뿐만 아니라 클래스별, 환자군별, 오류 유형별 변화 분석
Conclusion
배열 정보가 실제로 어떤 오류를 감소시켰는지 판단
과 같은 구조가 필요했다.
6.6 Root Cause F — 명확한 분기 기준의 부재
어떤 결과가 나오면 연구를 계속하고, 수정하고, 방향을 전환하고, 중단할 것인지 사전에 결정하지 않았다.
따라서 결과가 좋지 않더라도
"가설이 틀렸다"
고 판단하기보다
"다른 모델을 사용하면 될 수도 있다"
는 방향으로 실험이 계속될 수 있었다.
6.7 Root Cause G — AI 사용에 대한 연구자 통제력 상실
연구 질문과 실험 구조가 명확하지 않은 상황에서 AI를 반복적으로 사용하면서 연구 방향까지 AI의 제안에 영향을 받게 되었다.
AI는 원인이면서 동시에 앞선 문제들의 결과이기도 했다.
Research Question 부재
→ 다음 실험 기준 부재
→ AI에게 해결 방법 요청
→ 새로운 코드 및 방법 제안
→ 실행
→ 새로운 문제 발생
→ 다시 AI에게 해결 방법 요청
의 과정이 반복되었다.
6.8 Root Cause의 전체 연결
전체 문제를 하나의 흐름으로 연결하면 다음과 같다.
문제 발견
↓
문제의 실제 가치 검증 부족
↓
임상적 정답을 결정하는 데 필요한 정보 확인 부족
↓
현재 데이터로 해결 가능한지 검증 부족
↓
선행연구 및 Research Gap에 대한 충분한 검토 부족
↓
명확한 Research Question과 Hypothesis 부족
↓
Baseline과 성공·실패 기준 부재
↓
모델 구현부터 시작
↓
성능 수치 중심의 평가
↓
성능 변화 원인 분석 부족
↓
모델과 방법론 반복 변경
↓
AI 의존 증가
↓
연구 통제력 감소
↓
실험은 증가하지만 연구적 지식은 충분히 축적되지 않음
↓
연구 후반에 문제의 임상적 가치와 해결 가능성을 재검토
↓
연구 종료
7. Lessons Learned — 이번 연구에서 얻은 교훈
7.1 문제의 가치부터 검증해야 한다
기술적으로 해결할 수 있다고 해서 반드시 연구할 가치가 있는 것은 아니다.
먼저 실제 사용자가 겪고 있는 문제가 충분히 크며, 이를 해결했을 때 의미 있는 가치가 발생하는지를 검증해야 한다.
7.2 문제를 정의한 다음 해결 가능성을 검증해야 한다
문제를 발견했다고 바로 해결 방법을 만드는 것이 아니다.
먼저,
정답을 판단하려면 어떤 정보가 필요한가?
를 확인해야 한다.
그 다음,
현재 데이터에 그 정보가 존재하는가?
를 확인해야 한다.
이 조건이 만족된 이후에야 알고리즘과 모델을 고민해야 한다.
7.3 연구 질문과 가설을 먼저 정의해야 한다
코드를 작성하기 전에 최소한 다음 질문에 답할 수 있어야 한다.
- 무엇을 알고 싶은가?
- 어떤 가설을 검증하는가?
- 어떤 결과가 나오면 가설이 지지되는가?
- 어떤 결과가 나오면 가설을 수정하거나 기각해야 하는가?
7.4 배경 논문과 선행연구를 먼저 충분히 확인해야 한다
선행연구 조사는 Related Work를 작성하기 위해서만 하는 것이 아니다.
선행연구를 통해,
- 왜 이 문제가 중요한지
- 기존에는 어떻게 해결했는지
- 어떤 데이터를 사용했는지
- 어떤 Baseline을 사용했는지
- 어떤 평가 방법을 사용했는지
- 기존 방법이 어디에서 실패하는지
- 아직 해결되지 않은 Research Gap이 무엇인지
를 확인해야 한다.
새로운 연구 가설은 이러한 근거 위에서 설정되어야 한다.
7.5 데이터를 모델에 넣기 전에 이해해야 한다
데이터는 모델의 입력값이 아니라 연구 가설을 검증하기 위한 증거다.
따라서 데이터의 수집 목적, 환자군, GT 생성 방법, 오류, 편향, 필요한 정보의 존재 여부 등을 모델 학습 전에 확인해야 한다.
7.6 Baseline은 연구의 출발점이다
중요한 것은
"내 모델의 성능이 몇 %인가?"
가 아니라,
"기존 방법과 비교하여 무엇이 얼마나 달라졌으며 왜 달라졌는가?"
이다.
Baseline이 있어야 새로운 방법의 효과를 주장할 수 있다.
7.7 한 번의 실험에서는 하나의 질문을 검증해야 한다
가능한 한 다른 조건은 통제하고 검증하려는 요소만 변경해야 한다.
Hypothesis → Controlled Change → Measurement → Analysis
구조로 실험하여 무엇 때문에 결과가 변했는지를 설명할 수 있어야 한다.
7.8 성능 수치는 분석의 시작점이다
Accuracy, Recall, mAP 등의 숫자를 얻었다고 실험이 끝나는 것이 아니다.
Metric
→ 어디에서 변화했는가?
→ 왜 변화했는가?
→ 가설과 어떤 관계가 있는가?
→ 무엇을 결론 내릴 수 있는가?
까지 연결되어야 한다.
7.9 명확한 분기 시점과 판단 기준을 사전에 설정해야 한다
연구는 직선적으로 진행되는 것이 아니라 지속적으로 의사결정을 내리는 과정이다.
각 단계에서,
Continue / Modify / Pivot / Stop
의 판단 기준을 미리 설정해야 한다.
결과를 확인한 다음 기준을 만드는 것이 아니라, 가능한 경우 실험 전에 어떤 결과가 나오면 무엇을 할 것인지 정해두어야 한다.
7.10 AI는 구현을 돕는 도구로 사용해야 한다
생성형 AI는 코드 작성, 논문 탐색, 아이디어 검토 등에 적극적으로 사용할 수 있다.
그러나 연구자는 항상,
- 지금 무엇을 검증하는지
- 왜 이 방법을 사용하는지
- 코드가 무엇을 수행하는지
- 무엇을 변경했는지
- 결과가 무엇을 의미하는지
설명할 수 있어야 한다.
따라서 기본 구조는
Researcher defines question & experiment
→ AI assists implementation
이어야 한다.
7.11 연구 과정을 기록해야 한다
각 실험마다 최소한 다음을 기록한다.
- Research Question
- Hypothesis
- Background Evidence
- Baseline
- 변경 사항
- 실험 조건
- Evaluation Metric
- 결과
- Error Analysis
- Interpretation
- Decision
- 다음 실험의 이유
그래야 개별 실험들이 하나의 연구 논리로 축적된다.
8. Action Items — 다음 연구에서 실제로 바꿀 것
이번 연구에서 얻은 교훈을 다음 연구에서 실제 행동으로 전환하기 위해 다음 원칙을 적용한다.
연구 시작 전
- 해결하려는 문제를 한 문장으로 정의한다.
- 실제 사용자가 해당 문제를 겪고 있는지 확인한다.
- 문제 해결의 실질적 가치를 확인한다.
- 해당 분야 전문가가 실제로 문제를 어떻게 해결하는지 확인한다.
- 정답을 판단하는 데 필요한 정보를 정의한다.
- 현재 데이터에 해당 정보가 존재하는지 확인한다.
- 주요 배경 논문과 최신 선행연구를 조사한다.
- 기존 방법과 Research Gap을 정의한다.
실험 시작 전
- Research Question을 명시한다.
- Hypothesis를 명시한다.
- Baseline을 정의하거나 재현한다.
- 데이터셋과 GT의 품질을 검증한다.
- Evaluation Metric을 정한다.
- Success / Failure Criteria를 정한다.
- Continue / Modify / Pivot / Stop 분기 조건을 정한다.
각 실험에서
- 한 번에 가능한 한 하나의 변수만 변경한다.
- 변경 이유를 기록한다.
- Baseline과 동일한 조건에서 비교한다.
- 전체 성능뿐만 아니라 세부 오류를 분석한다.
- 결과가 가설을 지지하는지 판단한다.
- 결과를 근거로 다음 행동을 결정한다.
AI 사용 시
AI가 생성한 코드나 방법론을 연구에 적용하기 전에,
"내가 이 코드와 방법을 다른 사람에게 설명할 수 있는가?"
를 확인한다.
설명할 수 없다면 이해한 이후에 실험에 사용한다.
9. Final Summary — Post-mortem 결론
이번 연구는 MRI 영상에서 척추체를 자동 검출하고, 천추의 요추화와 요추의 천추화와 같은 해부학적 변이까지 고려하여 척추 레벨을 자동 라벨링하는 것을 목표로 시작하였다.
이를 통해 임상 연구자의 수작업 라벨링 시간을 줄이고 CNN 등 AI 연구에 필요한 GT 구축 부담을 감소시키고자 하였다.
그러나 연구를 돌아보면 가장 큰 문제는 특정 모델이나 알고리즘을 잘못 선택한 것이 아니었다.
문제를 발견한 이후 곧바로 해결 방법을 만드는 단계로 넘어간 것이 더 근본적인 문제였다.
문제를 발견했다면 먼저 세 가지 질문을 순서대로 검증했어야 한다.
1. Should we solve it? — 해결할 가치가 있는가?
실제 사용자에게 충분히 중요한 문제이며, 해결했을 때 의미 있는 가치가 발생하는가?
2. Can we solve it? — 해결 가능한가?
정답을 판단하기 위해 필요한 정보는 무엇이며, 현재 확보한 데이터에 그 정보가 존재하는가?
3. How should we solve it? — 어떻게 해결할 것인가?
기존 연구에서는 어떻게 해결하고 있으며, 어떤 한계가 존재하고, 어떤 가설과 방법으로 그 한계를 개선할 것인가?
이번 연구에서는 사실상 세 번째 질문인 How에서 연구를 시작했고, 연구가 진행된 이후에야 Should와 Can의 문제를 발견하였다.
특히 천추화와 요추화를 정확하게 판단하기 위해서는 전문의가 실제로 사용하는 해부학적 정보와 판단 과정을 먼저 이해했어야 했다. 제한된 MRI 영상 내부에서 Anchor와 척추 배열을 이용해 합리적인 결과를 추론하는 알고리즘을 만드는 것에 앞서, 임상적 정답을 결정하는 데 필요한 정보가 현재 데이터에 존재하는지부터 확인했어야 했다.
연구 수행 과정에서도 Research Question, Hypothesis, Dataset, Baseline, Evaluation Criteria를 충분히 정의하지 않은 상태에서 모델 개발을 시작하였다.
그 결과 모델의 절대적인 성능에 집중했고, 왜 해당 성능이 발생했는지와 변경 요소와 결과 사이의 관계를 충분히 분석하지 못하였다.
명확한 분기 기준이 없었기 때문에 문제가 발생하면 가설을 평가하기보다 모델과 방법론을 반복적으로 변경하였다. 생성형 AI 역시 이 과정에서 적극적으로 사용되면서 어느 순간 연구자가 연구를 설계하고 AI가 구현을 보조하는 것이 아니라, AI가 제시하는 방법을 반복적으로 실행하는 형태에 가까워졌다.
이번 Post-mortem을 통해 연구는 단순히 좋은 모델을 만드는 과정이 아니라는 것을 배웠다.
앞으로의 연구는 다음과 같은 구조로 진행해야 한다.
Problem Discovery
→ Problem Significance — Should we solve it?
→ Feasibility — Can we solve it?
→ Background & Literature Review
→ Research Gap
→ Research Question
→ Hypothesis
→ Dataset Understanding & Suitability
→ Baseline
→ Evaluation Metrics & Success Criteria
→ Controlled Experiment
→ Result & Error Analysis
→ Decision Point
→ Continue / Modify / Pivot / Stop
그리고 각각의 단계에는 다음 단계로 넘어가기 위한 명확한 근거와 분기 기준이 존재해야 한다.
이번 연구에서 얻은 가장 중요한 결과는 특정 척추체 라벨링 알고리즘이나 모델의 성능만이 아니다.
문제를 발견하는 것, 해결할 가치가 있는 문제인지 확인하는 것, 실제로 해결 가능한 문제인지 검증하는 것, 기존 연구에서 무엇이 해결되지 않았는지 확인하는 것, 가설을 세우고 통제된 실험으로 검증하는 것이 각각 서로 다른 연구 단계라는 사실을 실제 실패 과정을 통해 이해하게 된 것이 이번 연구에서 얻은 가장 큰 학습 결과이다.
'Portfolio (성과 & 활동) > [연구생] ADSLab' 카테고리의 다른 글
| CNN의 정의와 문제점 (0) | 2026.03.27 |
|---|---|
| [딥러닝 파이토치 교과서 1장] 머신러닝과 딥러닝 (0) | 2026.03.05 |
